교회도서관의 어려움은 책이 없어서가 아니라, 필요한 책을 만날 길이 보이지 않는 데서 시작되곤 한다.
주일 점심 뒤 교제실 한쪽을 지나다 보면 책장이 있다. 십수 년 전 은퇴하신 장로님이 기증하신 전집이 있고, 이사 가는 가정이 두고 간 상자 하나가 그대로 꽂혀 있고, 선교사 보고서와 오래된 설교집이 같은 칸에 섞여 있다. 목록은 몇 해 전 누군가가 손으로 정리한 공책이 마지막이다. 제목만으로는 어떤 질문에 도움이 되는 책인지 알기 어렵고, 성도는 "기도 책 어디 있어요?"라고 묻다가 그냥 돌아선다. 책이 없는 것이 아니라 책으로 가는 길이 닫혀 있는 것이다.
이 닫힌 길을 여는 데 생성형 AI가 쓰일 수 있을까. 다만 AI를 새 책을 골라 주는 권위자로 세우자는 이야기가 아니다. 이미 교회가 가진 책의 공개 서지정보를 정리하고, 사람이 만든 짧은 안내를 연결하는 보조 편집자로 쓰면 어떨까 하는 제안이다. 화려한 자동화가 아니라 잠든 책장을 다시 목회의 대화 속으로 불러오는 작은 활용 사례다.
미리 밝혀 둘 것이 있다. 특정 교회가 이 방식으로 도입 성과를 냈다거나 대출이 늘었다는 수치는 공개 자료로 확인하지 못했다. 그래서 여기서는 실적을 소개하지 않고, 확인 가능한 공개 도구를 바탕으로 한 시범 절차를 제안한다. 한 서가, 네 주, 서른 권이면 시작할 수 있다.
추천 엔진보다 먼저 필요한 것은 목록이다
처음부터 "우리 교인에게 맞는 책을 추천해 달라"고 묻는 것은 좋지 않다.
추천 대상의 나이, 상담 내용, 가족 형편, 신앙 고민을 모으기 시작하면 도서관 실험이 곧 민감정보를 다루는 사업으로 변한다. 암 투병 중인 성도에게 위로의 책을 권하려면 그 사실을 알아야 하고, 그 사실을 아는 순간 시스템은 누구도 맡아서는 안 될 기록을 쌓게 된다. 교회도서관에서 AI가 사람을 읽기 시작하면 도서관은 책을 소개하는 곳이 아니라 성도를 분류하는 곳이 된다.
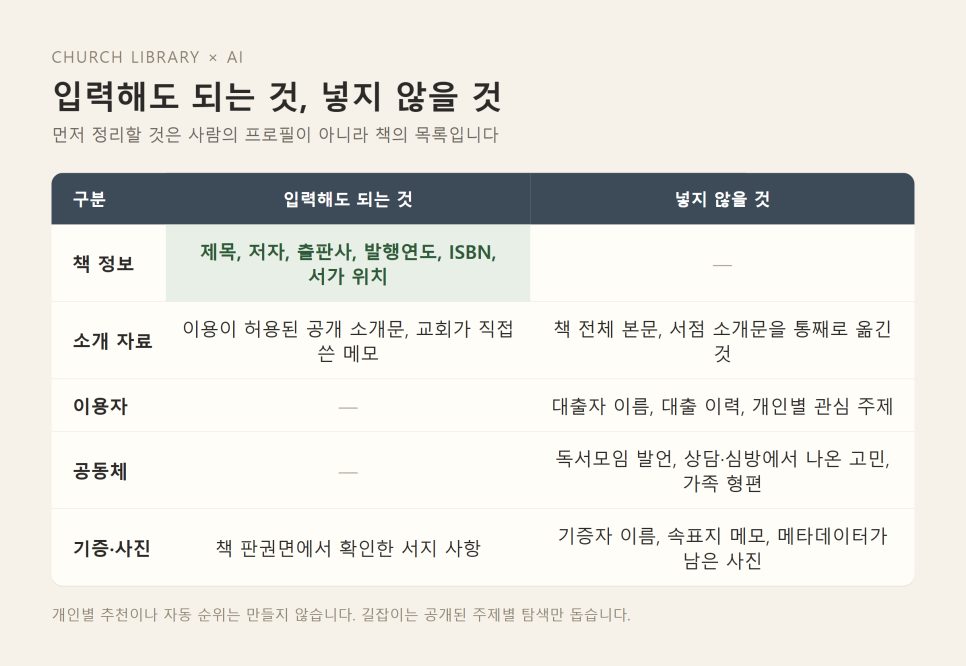
그러니 먼저 할 일은 사람의 프로필이 아니라 책의 목록을 정리하는 것이다. 쓰는 항목은 책 자체에 관한 것으로 한정한다. 제목, 저자, 출판사, 발행연도, ISBN, 교회가 정한 서가 위치. 반대로 대출자 이름, 대출 이력, 독서모임에서 나온 발언, 개인별 관심 주제는 어느 칸에도 입력하지 않는다.
그 목록 위에 이미 붙어 있는 분류가 있다면 버리지 말아야 한다. 한국십진분류법(KDC)에서 종교는 200번대이고 기독교는 230번이다. 그 아래로 231 기독교 신학·교의학, 232 예수 그리스도, 233 성서, 234 신앙생활, 235 전도·교육·목회학이 이어진다. 많은 교회도서관이 이 틀을 쓰거나 그 변형을 쓴다. 이 번호는 책이 서가의 어디에 꽂히는가를 알려 주는 좌표다. 우리가 만들려는 주제 길잡이는 그 좌표를 바꾸는 것이 아니라, 질문하는 사람이 서가 앞에서 길을 찾도록 입구를 한 겹 더 달아 주는 일이다. 청구기호는 그대로 두고 "기도를 시작하고 싶을 때"라는 입구에서 그 청구기호로 이어 주는 식이다.
서지정보는 공개 목록과 대조한다
서지정보를 보완할 때는 기억이나 AI의 추측보다 공개 목록을 대조해야 한다. 책 제목 하나, 저자 이름 한 글자가 틀리면 성도는 그 책을 찾지 못하고, 찾지 못하면 길잡이 전체를 믿지 않게 된다.
후보로 삼을 만한 공개 출처가 몇 있다. 구글은 Google Books API로 도서 검색과 책 정보 조회를 지원한다. 제목, 저자, ISBN 같은 조건으로 검색할 수 있고 한 번에 가져오는 최대 건수가 정해져 있다. 공개된 정보만 요청해도 API 키가 필요하다는 점은 미리 알아 두어야 한다. 미국 의회도서관은 loc.gov의 검색 결과와 개별 자료를 JSON이나 YAML로 받을 수 있게 안내한다. 인증은 필요 없지만 요청 횟수 제한이 있고, 도서관 목록 레코드는 이 인터페이스에 포함되지 않는다. 목록 레코드 전체가 필요하다면 별도로 공개된 MARC 데이터 세트를 보아야 한다.
한국어 책이 중심인 교회라면 국내 출처가 먼저다. 국립중앙도서관은 한국서지표준센터를 통해 ISBN 서지정보 Open API를 제공한다. 표제, 저자, ISBN, 발행처, 한국십진분류 같은 항목이 들어 있고, 사용하려면 인증키를 발급받아야 한다. 출판사 누리집과 공공도서관의 공개 서지도 같은 역할을 한다.
솔직히 덧붙이면, 여기서는 이 API들을 직접 호출해 결과의 품질을 시험하지 않았고, 한국어 도서를 어디까지 포괄하는지도 확인하지 않았다. 그러므로 이들은 자동 정답지가 아니다. 제목·저자·판본을 다시 확인해 볼 후보 출처일 뿐이다. 마지막 확인은 언제나 책 뒷면의 판권면, 곧 실물이 한다.
AI가 할 일은 분류의 초안까지다
정리된 목록이 생기면 AI에게는 책마다 세 가지 초안만 요청한다.
첫째, 제목과 공개 소개문에서 드러나는 주제어 다섯 개. 둘째, "이 책은 무엇을 묻는가"를 설명하는 두 문장. 셋째, 관련 서가로 이어지는 연결어. 예를 들어 '기도'라는 넓은 표지만 붙이지 말고 공동기도, 탄식, 일상 영성, 예배 인도처럼 실제 탐색에 도움이 되는 후보를 내게 한다. 정보가 부족하면 내용을 채워 쓰지 말고 '목차 확인 필요'라고 표시하게 한다.
프롬프트의 뼈대는 이 정도면 된다.
아래는 책의 제목, 저자, 출판사와 공개 소개문입니다.
이 자료에 나온 내용만 근거로 주제어 5개와 두 문장 안내를 쓰세요.
추측하거나 인용문을 만들지 마세요.
근거가 부족하면 '목차 확인 필요'라고만 쓰세요.
중요한 것은 AI가 책을 읽었다고 가장하지 못하게 하는 일이다. 제목과 출판사 소개만 제공했다면 결과에도 "공개 서지와 소개문을 바탕으로 한 임시 분류"라고 적는다. 서평처럼 보이는 문장, 저자의 결론을 단정하는 문장, 본문에 없는 인용문은 지운다. AI는 읽지 않은 책에 대해서도 읽은 사람처럼 매끄럽게 쓴다. 그 매끄러움이 가장 위험하다.
저작권도 챙겨야 한다. 저작권이 있는 책 전체를 외부 서비스에 올리지 않는다. 사용하는 것은 이용이 허용된 공개 소개와 교회가 직접 작성한 메모로 최소한만 한다. 저작권법 제28조는 공표된 저작물을 보도·비평·교육·연구 등을 위해 정당한 범위 안에서 공정한 관행에 맞게 인용할 수 있다고 하지만, 서점 누리집의 소개문을 통째로 옮겨 안내판에 붙이는 일까지 허용한다는 뜻은 아니다. 짧게 인용하고 출처를 밝히거나, 담당자가 자기 말로 요약하는 쪽이 안전하다. 표지 이미지도 자동으로 모으기 전에 이용 조건부터 확인한다.
목회자는 '무엇을 권할지'보다 '어떻게 만날지'를 본다
주제표에는 신학적 검토가 필요하다.
같은 '회복'이라는 말도 애도, 중독, 관계 갈등, 성공 담론에서 전혀 다르게 쓰인다. AI가 비슷한 단어를 묶었다고 같은 목회적 처방이 되는 것은 아니다. '은혜'라는 단어 하나만 해도 어떤 책에서는 칭의를 말하고 어떤 책에서는 기분 좋은 긍정을 말한다. 목회자나 훈련된 담당자는 교리적 위치를 단정하기보다, 독자가 판단할 수 있는 설명을 남긴다. "개혁주의", "상담용", "청소년 필독" 같은 검토 책임이 큰 딱지는 근거 없이 자동으로 붙이지 않는다. 한 번 붙은 딱지는 책 앞에서 성도의 발걸음을 막기도 하고 부르기도 한다.
또 책 추천을 상담의 대체물로 만들지 않는다. 누군가 깊은 슬픔이나 위기를 말했을 때 화면이 즉시 책 세 권을 내놓는 것은 돌봄이 아니다. 길잡이는 공개된 주제별 탐색을 돕고, 개인의 사정을 듣고 동행하는 일은 사람이 맡는다. 서가 앞에서 한참 서성이는 성도에게 "찾는 책 있으세요?" 하고 먼저 물어 주는 사서 봉사자의 한마디가 어떤 시스템보다 낫다.
신학적 논쟁이 있는 주제에는 한 권을 정답으로 올리기보다 서로 다른 관점을 함께 소개하고, 왜 함께 읽는지 짧게 설명한다. 분류에서 반복해서 빠지는 목소리가 없는지도 사람이 살핀다. 여성 저자, 장애인, 이주민, 비서구 저자의 책이 '기타' 칸으로 밀려나 있지는 않은지 본다.
네 주 동안 한 서가만 시험한다
첫째 주에는 공개 가능한 소장 목록에서 서른 권만 고른다. 개인 기증자의 이름이나 대출 기록은 제거하고, 실물 책의 판권면과 공개 서지를 대조해 제목·저자·판본을 확정한다. 둘째 주에는 승인된 소개문만 AI에 넣어 주제어와 두 문장 길잡이를 받는다. 프롬프트에는 "추측 금지, 인용 생성 금지, 근거가 부족하면 확인 필요 표시"를 분명히 적는다.
셋째 주에는 두 사람이 각각 결과를 검토한다. 한 사람은 서지 일치와 저작권 범위를, 다른 한 사람은 신학적 뉘앙스와 낙인 가능성을 본다. 수정할 때는 AI 문장을 매끈하게 다듬는 데서 멈추지 않고, 채택·수정·보류의 이유를 한 줄씩 남긴다. 넷째 주에는 QR 코드나 공개 웹페이지보다 먼저 종이 한 장짜리 주제 지도를 서가 앞에 놓는다. "기도를 시작하고 싶을 때", "교회의 의미를 다시 묻고 싶을 때" 같은 입구와 책 위치만 적는다. 개인별 추천이나 자동 순위는 만들지 않는다.
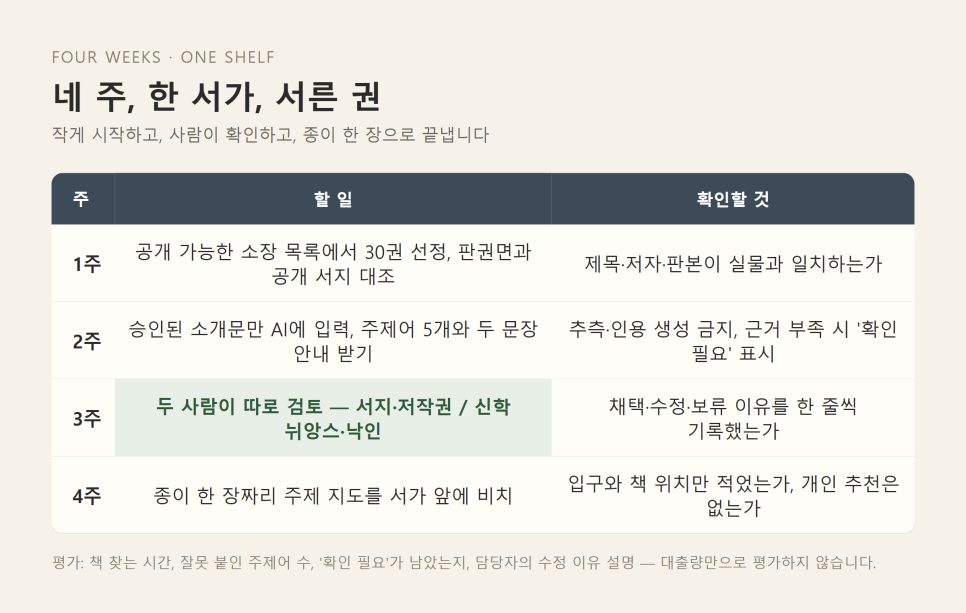
평가는 대출량 하나로 하지 않는다. 서가에서 책을 찾는 시간이 줄었는지, 잘못 붙인 주제어가 몇 개인지, '확인 필요'가 제대로 남았는지, 담당자가 수정 이유를 설명할 수 있는지를 본다. 대출이 늘지 않아도 길잡이는 실패하지 않을 수 있다. 책을 빌리지 않고 서가 앞에서 한참 읽다 가는 사람도 길을 찾은 사람이다.
여기서 NIST의 AI 위험관리 프레임워크가 도움이 된다. 이 프레임워크의 핵심은 네 가지 기능, 곧 Govern, Map, Measure, Manage다. 책임 구조를 세우고, 위험을 파악하고, 성능과 위험을 측정하고, 대응책을 운영하라는 흐름이다. 교회도서관 시범에 옮기면 이런 모습이 된다. 담당자와 최종 승인자를 정한다. 이 작은 용도의 위험이 무엇인지 적는다. 오류 개수를 센다. 고치고 멈출 기준을 정한다. NIST 문서는 자발적으로 쓰는 프레임워크이고 개정도 진행 중이다. 이것이 교회도서관의 품질을 보증해 주지는 않는다. 다만 "일단 만들고 보자"는 태도를 막아 주는 정도로는 충분히 쓸모가 있다. 교회의 다른 AI 활용에도 같은 틀을 적용하려면 앞서 정리한 위험대장 글을 함께 보면 좋다.
일곱 질문으로 검수한다
검수표에는 최소한 다음 일곱 가지 질문을 둔다.
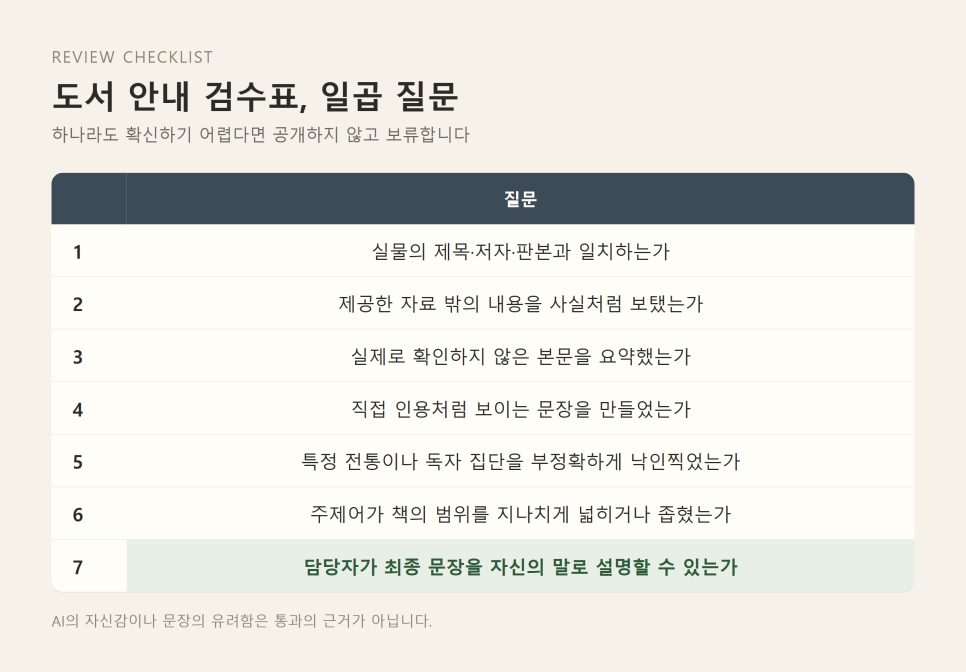
실물의 제목·저자·판본과 일치하는가. 제공한 자료 밖의 내용을 사실처럼 보탰는가. 실제로 확인하지 않은 본문을 요약했는가. 직접 인용처럼 보이는 문장을 만들었는가. 특정 전통이나 독자 집단을 부정확하게 낙인찍었는가. 주제어가 책의 범위를 지나치게 넓히거나 좁혔는가. 담당자가 최종 문장을 자신의 말로 설명할 수 있는가.
하나라도 확신하기 어렵다면 공개하지 않고 보류한다. AI의 자신감이나 문장의 유려함은 통과의 근거가 아니다. 마지막 질문이 특히 중요하다. 성도가 "이 설명, 무슨 뜻이에요?" 하고 물었을 때 담당자가 "AI가 그렇게 썼어요"라고밖에 답하지 못한다면, 그 문장은 아직 교회의 문장이 아니다.
오류 기록도 공개용 길잡이와 분리해서 남긴다. 책 제목, 생성 날짜, 사용한 입력 범위, 발견한 오류 유형, 수정한 사람의 역할, 재검토 날짜 정도면 충분하다. 모델에 넣은 프롬프트와 결과에 민감정보가 없는지 다시 확인하고, 서비스가 입력을 어떻게 저장하고 이용하는지는 사용하는 시점의 공식 개인정보 문서에서 확인한다. 보존 기간과 학습 이용 여부를 확인할 수 없다면 외부 도구 대신 로컬 표 계산과 수동 태깅으로 돌아간다. 무료라는 이유로 자료 처리 조건을 건너뛰지 않는다. 기증 도서의 속표지에 적힌 이름이나 메모 사진을 올리는 일도 마찬가지다. 사진 속 정보가 새어 나가지 않도록 사진 메타데이터 점검 글에서 정리한 관문을 거치는 것이 좋다.
시범을 공개한 뒤에는 익명 의견 상자에 질문 두 개만 둔다. "원한 주제로 이동할 수 있었는가", "설명이 책의 실제 내용과 달랐는가." 신앙 고민이나 독서 취향을 수집하지 않아도 길잡이가 쓸모 있는지는 확인할 수 있다. 특히 잘못 분류된 책을 발견한 이용자가 쉽게 알릴 수 있어야 한다. 수정 요청은 실패의 증거가 아니라, 자동 분류를 공동체의 책임 아래 두는 정상적인 운영 절차다.
책을 고르는 공동체의 책임
검색창이 생긴다고 독서 공동체가 생기지는 않는다.
좋은 길잡이는 사람을 화면에 오래 붙잡지 않고 책과 대화, 그리고 함께 읽는 자리로 보낸다. 분기마다 분류표를 다시 열어 절판·개정판·오류를 고치고, 이용자가 "이 설명은 책과 다르다"고 말할 수 있는 수정 창구를 둔다. 도구나 모델이 바뀌면 기존 결과도 표본을 뽑아 다시 검사한다.
교회도서관에서 AI가 맡을 수 있는 가장 건강한 자리는 사서나 목회자의 자리가 아니라, 먼지 쌓인 목록에 임시 색인을 붙이는 작업대에 가깝다. 책의 의미를 최종 판단하고, 무엇을 함께 읽을지 정하고, 읽은 뒤의 질문을 받아 주는 책임은 공동체에 남는다. 그 책임이 사람에게 있을 때 AI는 사람을 분류하는 기술이 아니라, 사람이 잊고 있던 책을 다시 만나게 하는 조용한 도구가 될 수 있다.
이번 달 교제실 책장 앞에 서서 서른 권만 골라 보면 어떨까. 책등을 한 권씩 꺼내 판권면을 펴 보는 그 시간이, 잠들어 있던 책장을 다시 여는 첫걸음이다.
함께 읽기
교회 AI 위험대장 만들기 | 도입 전 한 장으로 정하는 책임선
https://blog.naver.com/haramprok/224425311627
교회 AI 위험대장 만들기 | 도입 전 한 장으로 정하는 책임선 ↗
ExifTool·mat2로 사진 메타데이터 확인 | AI 업로드 전 교회 사진 관문
https://blog.naver.com/haramprok/224427457695
ExifTool·mat2로 사진 메타데이터 확인 | AI 업로드 전 교회 사진 관문 ↗
참고 자료
Using the API, Google Books APIs (확인: 2026.10.5)
JSON/YAML for LoC.gov, Library of Congress (확인: 2026.10.5)
ISBN 서지정보 Open API, 국립중앙도서관 서지정보유통지원
AI Risk Management Framework, NIST AI Resource Center (확인: 2026.10.5)
AI RMF Playbook, NIST AI Resource Center (확인: 2026.10.5)
한국십진분류법(KDC) 종교 분류 요목, 저작권법 제28조(공표된 저작물의 인용)
이 글은 손하람 목사의 창가에 2026. 10. 5에 올린 글을 옮긴 것입니다.